Transkription für Interviews und Forschung
Qualitative Forschung lebt von Interviews und Fokusgruppen, und das Material summiert sich schnell. Einwilligungserklärungen versprechen Teilnehmenden eine Vertraulichkeit, die schwer zu halten ist, sobald Audio in eine fremde Cloud hochgeladen wird. Scriber läuft auf dem eigenen Server deiner Institution, sodass die Aufnahmen ihn nie verlassen müssen.
Stunden an Material, im eigenen Haus
Ein einziger Tag Feldarbeit kann Stunden an Interview- oder Fokusgruppenaufnahmen liefern. Von Hand transkribiert dauert dieses Material deutlich länger als die Gespräche selbst, und der Rückstand wächst mit jeder weiteren Sitzung im Projekt.
Einwilligungserklärungen der Teilnehmenden und institutionelle Datenrichtlinien schließen den Upload von Audiomaterial zu einem Cloud-Dienst häufig aus. Scriber wird auf dem eigenen Server deiner Institution installiert und verarbeitet jede Aufnahme dort, sodass das Material das Haus nie verlassen muss, um zum Transkript zu werden.
Sprecherinnen und Sprecher standardmäßig getrennt
In einer Fokusgruppe zählt, wer etwas gesagt hat, ebenso wie der Inhalt selbst. Scribers eigenes Sprechertrennungs-Modell ordnet jeden Beitrag automatisch der Person zu, die ihn geäußert hat, ohne manuelle Beschriftung.
Das Ergebnis ist ein Transkript, das sich in einer Publikation oder einem Bericht zitierfähig verwenden lässt: Aussagen bleiben über die gesamte Aufnahme hinweg durchgängig der jeweiligen teilnehmenden Person zugeordnet.
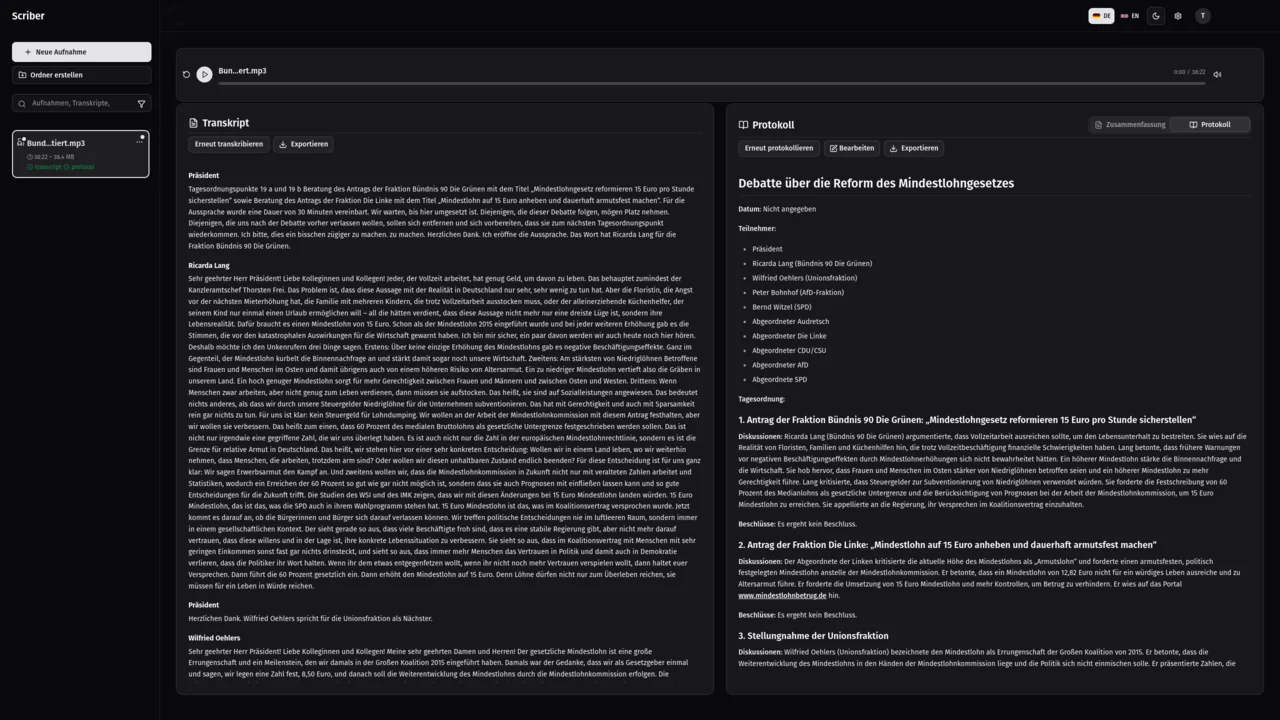
Ein ganzer Bestand an Aufnahmen, von selbst transkribiert
Aufnahmen aus dem Feld treffen selten einzeln ein. Scriber nimmt sie per manuellem Upload, aus einem überwachten Ordner auf dem Server, aus einem S3-kompatiblen Bucket oder von einer Netzwerkfreigabe entgegen und arbeitet ab, was eintrifft, ohne dass jemand die Anwendung öffnen muss.
Ist ein Bestand transkribiert, durchsuchst du die gesamte Bibliothek nach einer Passage, statt einzelne Audiodateien durchzuhören.
Sammeln
Aufnahmen aus Interviews und Fokusgruppen entstehen im Feld.
Einspielen
Dateien erreichen Scriber per Upload, aus einem überwachten Ordner, einem S3-kompatiblen Bucket oder einer Netzwerkfreigabe.
Transkribieren
Jede Aufnahme wird bei Eintreffen transkribiert und sprechergetrennt, ohne dass jemand die Anwendung öffnet.
Analysieren
Durchsuche die Bibliothek nach einer Passage und exportiere sie in deinen Codierungs-Workflow.
In deine Analysewerkzeuge
Ein fertiges Transkript nützt nur, wenn es in die Werkzeuge gelangt, die du bereits für Codierung und Analyse verwendest. Exportiere es als Text, Markdown, JSON, Word oder PDF und bring Interview- und Fokusgruppenmaterial ohne manuelle Neuformatierung in deinen bestehenden Arbeitsablauf.
Auch Projektbesprechungen hinterlassen ihre eigene Aufzeichnung. Scriber erstellt daraus ebenfalls eine Zusammenfassung und ein fertiges Protokoll, sodass sich die internen Abstimmungen des Forschungsteams ebenso leicht nachvollziehen lassen wie die Interviewdaten selbst.
Häufig gestellte Fragen
Kann Scriber qualitative Forschungsinterviews transkribieren?
Ja. Scriber transkribiert Interview- und Fokusgruppenaufnahmen auf dem eigenen Server deiner Institution, Wort für Wort, mit jedem Beitrag der sprechenden Person zugeordnet. Das Transkript ist bereit für Codierung und Analyse, und weder die Aufnahme noch der entstehende Text verlassen zu irgendeinem Zeitpunkt deine Infrastruktur.
Wie werden Sprecherinnen und Sprecher in einer Fokusgruppe unterschieden?
Jeder Beitrag einer Fokusgruppenaufnahme wird durch Scribers eigenes Sprechertrennungs-Modell automatisch der jeweiligen sprechenden Person zugeordnet, während die Aufnahme transkribiert wird. Aussagen bleiben im gesamten Transkript durchgängig zugeordnet, sodass sich die Mitschrift in Analyse oder Publikation zitierfähig verwenden lässt.
Können wir ein ganzes Archiv an Aufnahmen transkribieren lassen?
Ja. Richte einen überwachten Ordner auf dem Server, einen S3-kompatiblen Bucket oder eine Netzwerkfreigabe auf dein Archiv, und Scriber transkribiert jede Aufnahme unbeaufsichtigt, während es sich durch das Material arbeitet. Jedes Ergebnis landet in einer durchsuchbaren Bibliothek, in der du eine Passage über das gesamte Archiv hinweg findest, statt Datei für Datei zu suchen.
Was müssen Einwilligungserklärungen der Teilnehmenden berücksichtigen?
Da die Verarbeitung ausschließlich auf der eigenen Infrastruktur deiner Institution stattfindet, erhält kein Auftragsverarbeiter die Audiodaten, und keine Aufnahme wird an Dritte übermittelt. Aufbewahrung, Speicherort und Löschung bleiben Entscheidungen, die deine Institution auf eigenen Systemen trifft. Das unterstützt die Vertraulichkeit, die die meisten Einwilligungserklärungen versprechen; die konkrete Formulierung für deine Studie klärt deine Ethikkommission.
Forschungsdaten im eigenen Haus behalten
Sprich mit uns über die Transkription deiner Interviews und Fokusgruppen auf deiner eigenen Infrastruktur.