Automatische Meeting-Transkription, ohne Zutun
Automatische Meeting-Transkription bedeutet: Aufnahmen gehen hinein, fertige Dokumente kommen heraus, ohne dass jemand den Vorgang von Hand anstößt. Zeige Scriber den Ort, an dem deine Aufnahmen ohnehin landen, und jede eintreffende Datei wird eigenständig transkribiert, zusammengefasst und zu einem Protokoll verarbeitet. Diese Seite beschreibt die Pipeline ausführlich, für alle, die bereits einen ganzen Bestand an Aufnahmen aufzuarbeiten haben.
Wie Aufnahmen zu Scriber gelangen
Niemand muss Scriber öffnen, um eine Transkription zu starten. Aufnahmen aus deinem Konferenzsystem, deiner Telefonanlage oder einem Diktiergerät können in einen überwachten Ordner auf dem Server, einen S3-kompatiblen Bucket oder eine eingebundene Netzwerkfreigabe gelegt werden, die Scriber beobachtet.
Sobald eine Datei an einem dieser Orte erscheint, bemerkt Scriber sie und beginnt mit der Verarbeitung. Es gibt keine Warteschlange zu prüfen und keinen Upload-Schritt, an den jemand denken müsste; die Pipeline wartet einfach darauf, dass Aufnahmen eintreffen.
Vom Mitschnitt zum fertigen Protokoll
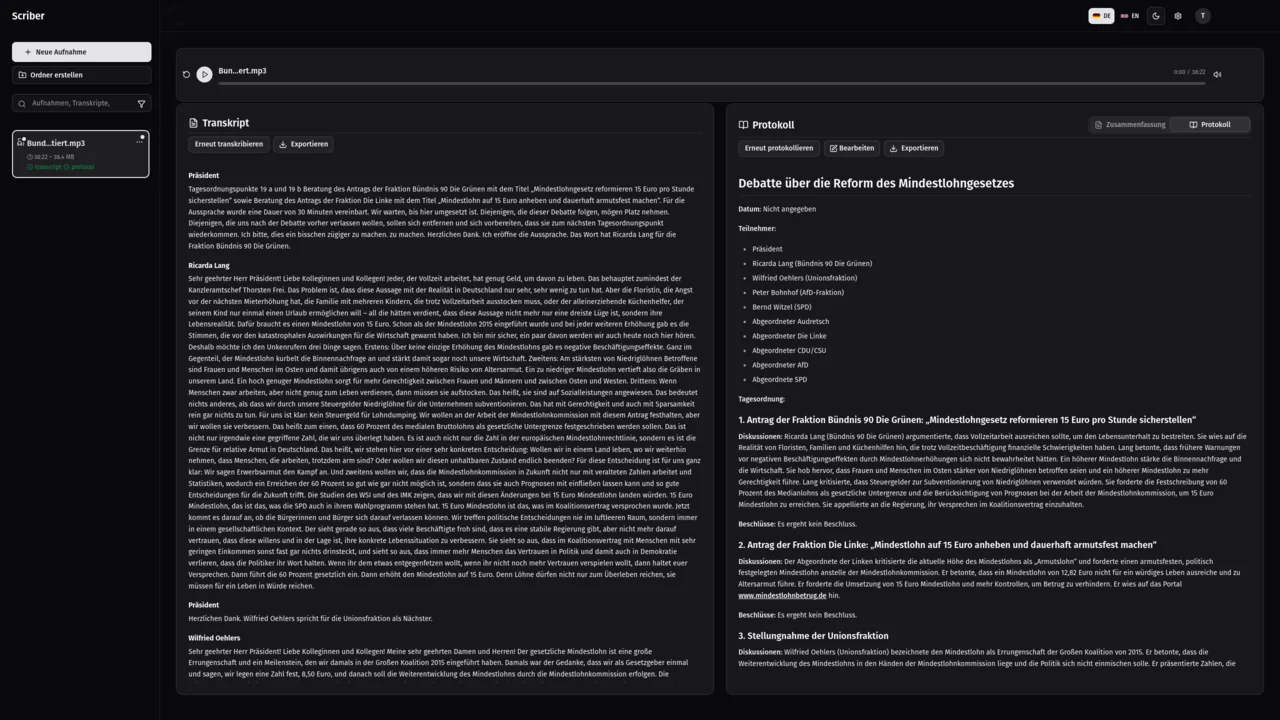
Jede Aufnahme wird sprechergetrennt transkribiert, sodass die Mitschrift zeigt, wer was gesagt hat. Aus diesem Transkript erstellt Scriber eine kurze Zusammenfassung der Diskussion und anschließend das fertige Protokoll: Titel, Datum, Teilnehmer und jeder Tagesordnungspunkt mit Diskussion und gefasstem Beschluss.
Aufnahme, Transkript und Protokoll werden zugleich in deiner durchsuchbaren Bibliothek abgelegt, zusammen mit allem, was Scriber sonst erzeugt hat. Ein automatisch entstandenes Dokument lässt sich damit später ebenso leicht wiederfinden wie eines, das du selbst aufgezeichnet hast.
Aufnahme trifft ein
Eine Datei erscheint in dem Ordner, Bucket oder der Freigabe, die Scriber beobachtet. Weitere Angaben dazu sind nicht nötig.
Scriber verarbeitet sie
Transkript, Zusammenfassung und Protokoll entstehen ohne manuellen Schritt. Auch die Sprechertrennung erfolgt in diesem Schritt.
Fertige Dokumente liegen vor
Die Ergebnisse werden zurückgeschrieben und zugleich in der Bibliothek abgelegt. Niemand muss diesen Schritt anstoßen oder begleiten.
Zustellung, ohne eine Oberfläche zu öffnen
Das fertige Transkript, die Zusammenfassung und das Protokoll werden als PDF, Word, Text, Markdown oder JSON ausgegeben und direkt in den Ordner oder die Netzwerkfreigabe geschrieben, die du bei der Einrichtung festgelegt hast. Niemand muss sich anmelden, eine Warteschlange prüfen oder einen Export anstoßen.
Die Browser-Oberfläche bleibt für Aufnahme, Suche und Durchsicht verfügbar, aber die automatische Transkription ist nicht auf sie angewiesen. Sie läuft unbeaufsichtigt in deinem Netzwerk, solange Aufnahmen eintreffen, ob einmal täglich oder fortlaufend.
Automatisch und weiterhin On-Premise
Die gesamte Pipeline, vom Eintreffen über die Transkription bis zur Zustellung, läuft auf derselben selbst gehosteten, On-Premise-Infrastruktur, die unsere anderen Seiten beschreiben: auf deinen eigenen Servern, ohne dass etwas hochgeladen werden muss, um sie zu erreichen. Automatisch bedeutet nur, dass niemand die Oberfläche bedienen muss, nicht, dass etwas deine Kontrolle verlässt; Aufnahmen, Transkripte und Protokolle kommen nie weiter als bis zu dem Speicher, den du bereits gewählt hast. Wenn sich bei dir Aufnahmen stapeln, weil niemand Zeit zum Transkribieren findet, ist genau dieser Rückstand der Fall, für den die Pipeline gedacht ist.
Häufig gestellte Fragen
Wie gelangen Aufnahmen automatisch in Scriber?
Zeige Scriber auf einen überwachten Ordner auf dem Server, einen S3-kompatiblen Bucket oder eine eingebundene Netzwerkfreigabe. Aufnahmen aus deinem Konferenzsystem, deiner Telefonanlage oder einem Diktiergerät landen dort, und Scriber holt jede ab, sobald sie eintrifft, ohne dass jemand etwas von Hand hochlädt.
Welche Dokumente erstellt Scriber aus einer Aufnahme?
Ein sprechergetrenntes Transkript, eine kurze Zusammenfassung der Diskussion und ein fertiges Protokoll mit Titel, Datum, Teilnehmern sowie Diskussion und Beschluss zu jedem Tagesordnungspunkt. Alle drei werden zusätzlich in deiner durchsuchbaren Bibliothek neben der Originalaufnahme abgelegt.
Muss für die automatische Transkription jemand die Oberfläche bedienen?
Nein. Die Browser-Oberfläche dient der Aufnahme, der Suche und der Durchsicht von Transkripten, nicht dem Betrieb der Pipeline. Sobald ein Ordner, Bucket oder eine Freigabe überwacht wird, werden Aufnahmen abgeholt, transkribiert und zugestellt, ohne dass jemand Scriber überhaupt öffnet.
Wie erhalten wir die fertigen Dokumente zurück?
Als PDF, Word, Text, Markdown oder JSON, zugestellt in den Ordner oder die Netzwerkfreigabe, die du bei der Einrichtung festgelegt hast. Alles bleibt zusätzlich in der durchsuchbaren Bibliothek erhalten, sodass sich ein Transkript oder Protokoll auch ohne den Export später wiederfinden lässt.
Automatisiere deine Meeting-Transkription
Sag uns, wo deine Aufnahmen landen, und wir zeigen dir, wie die Pipeline zu deiner Infrastruktur passt.